SQL braucht sehr große Kapazität? SQL Hyperscale konfigurieren
Wenn eine Anwendung über Jahre Bestellungen oder Transaktionen sammelt, kann ihre Datenbank die Speichergrenze erreichen. Eine große Datenbank für mehr Kapazität zu verschieben kostet außerdem Zeit, während mehr gespeicherte Daten nicht automatisch mehr CPU benötigen. Azure SQL Hyperscale trennt deshalb die Abfrageverarbeitung vom verteilten Speicher: Der Speicher wächst mit den Daten, und die Rechenkapazität lässt sich unabhängig anpassen.
Eine Datenbank vorbereiten
Verwende sqldb-cloudtrips auf sql-ctappweu in rg-cloudtrips-sql-test-weu aus Azure SQL Database erstellen. Erstelle sie erneut, falls gelöscht; verwende gegebenenfalls deinen abweichenden Servernamen.
Gehört sie zu pool-ctshared, öffne Compute + storage der Datenbank und verschiebe sie in eine eigenständige Standard-S0-Datenbank (10 DTUs). Bei Basic wechsle zuerst zu Standard S0: Eine direkte Konvertierung von Basic nach Hyperscale wird nicht unterstützt. Warte auf den Abschluss.
Hyperscale konfigurieren
Öffne Compute + storage und wähle:
Service tier: Hyperscale
Compute tier: Provisioned
Hardware: Standard-series (Gen5)
vCores: 2
High-availability secondary replicas: 0
Zone redundancy: Disabled
Cutover mode: Automatic
Prüfe die angezeigten Kosten und wähle Apply. Ein vCore ist ein virtueller CPU-Kern. Dieses kleine Lab verwendet zwei Kerne zum Kennenlernen der Konfiguration; die Produktionsgröße hängt von der Last ab.
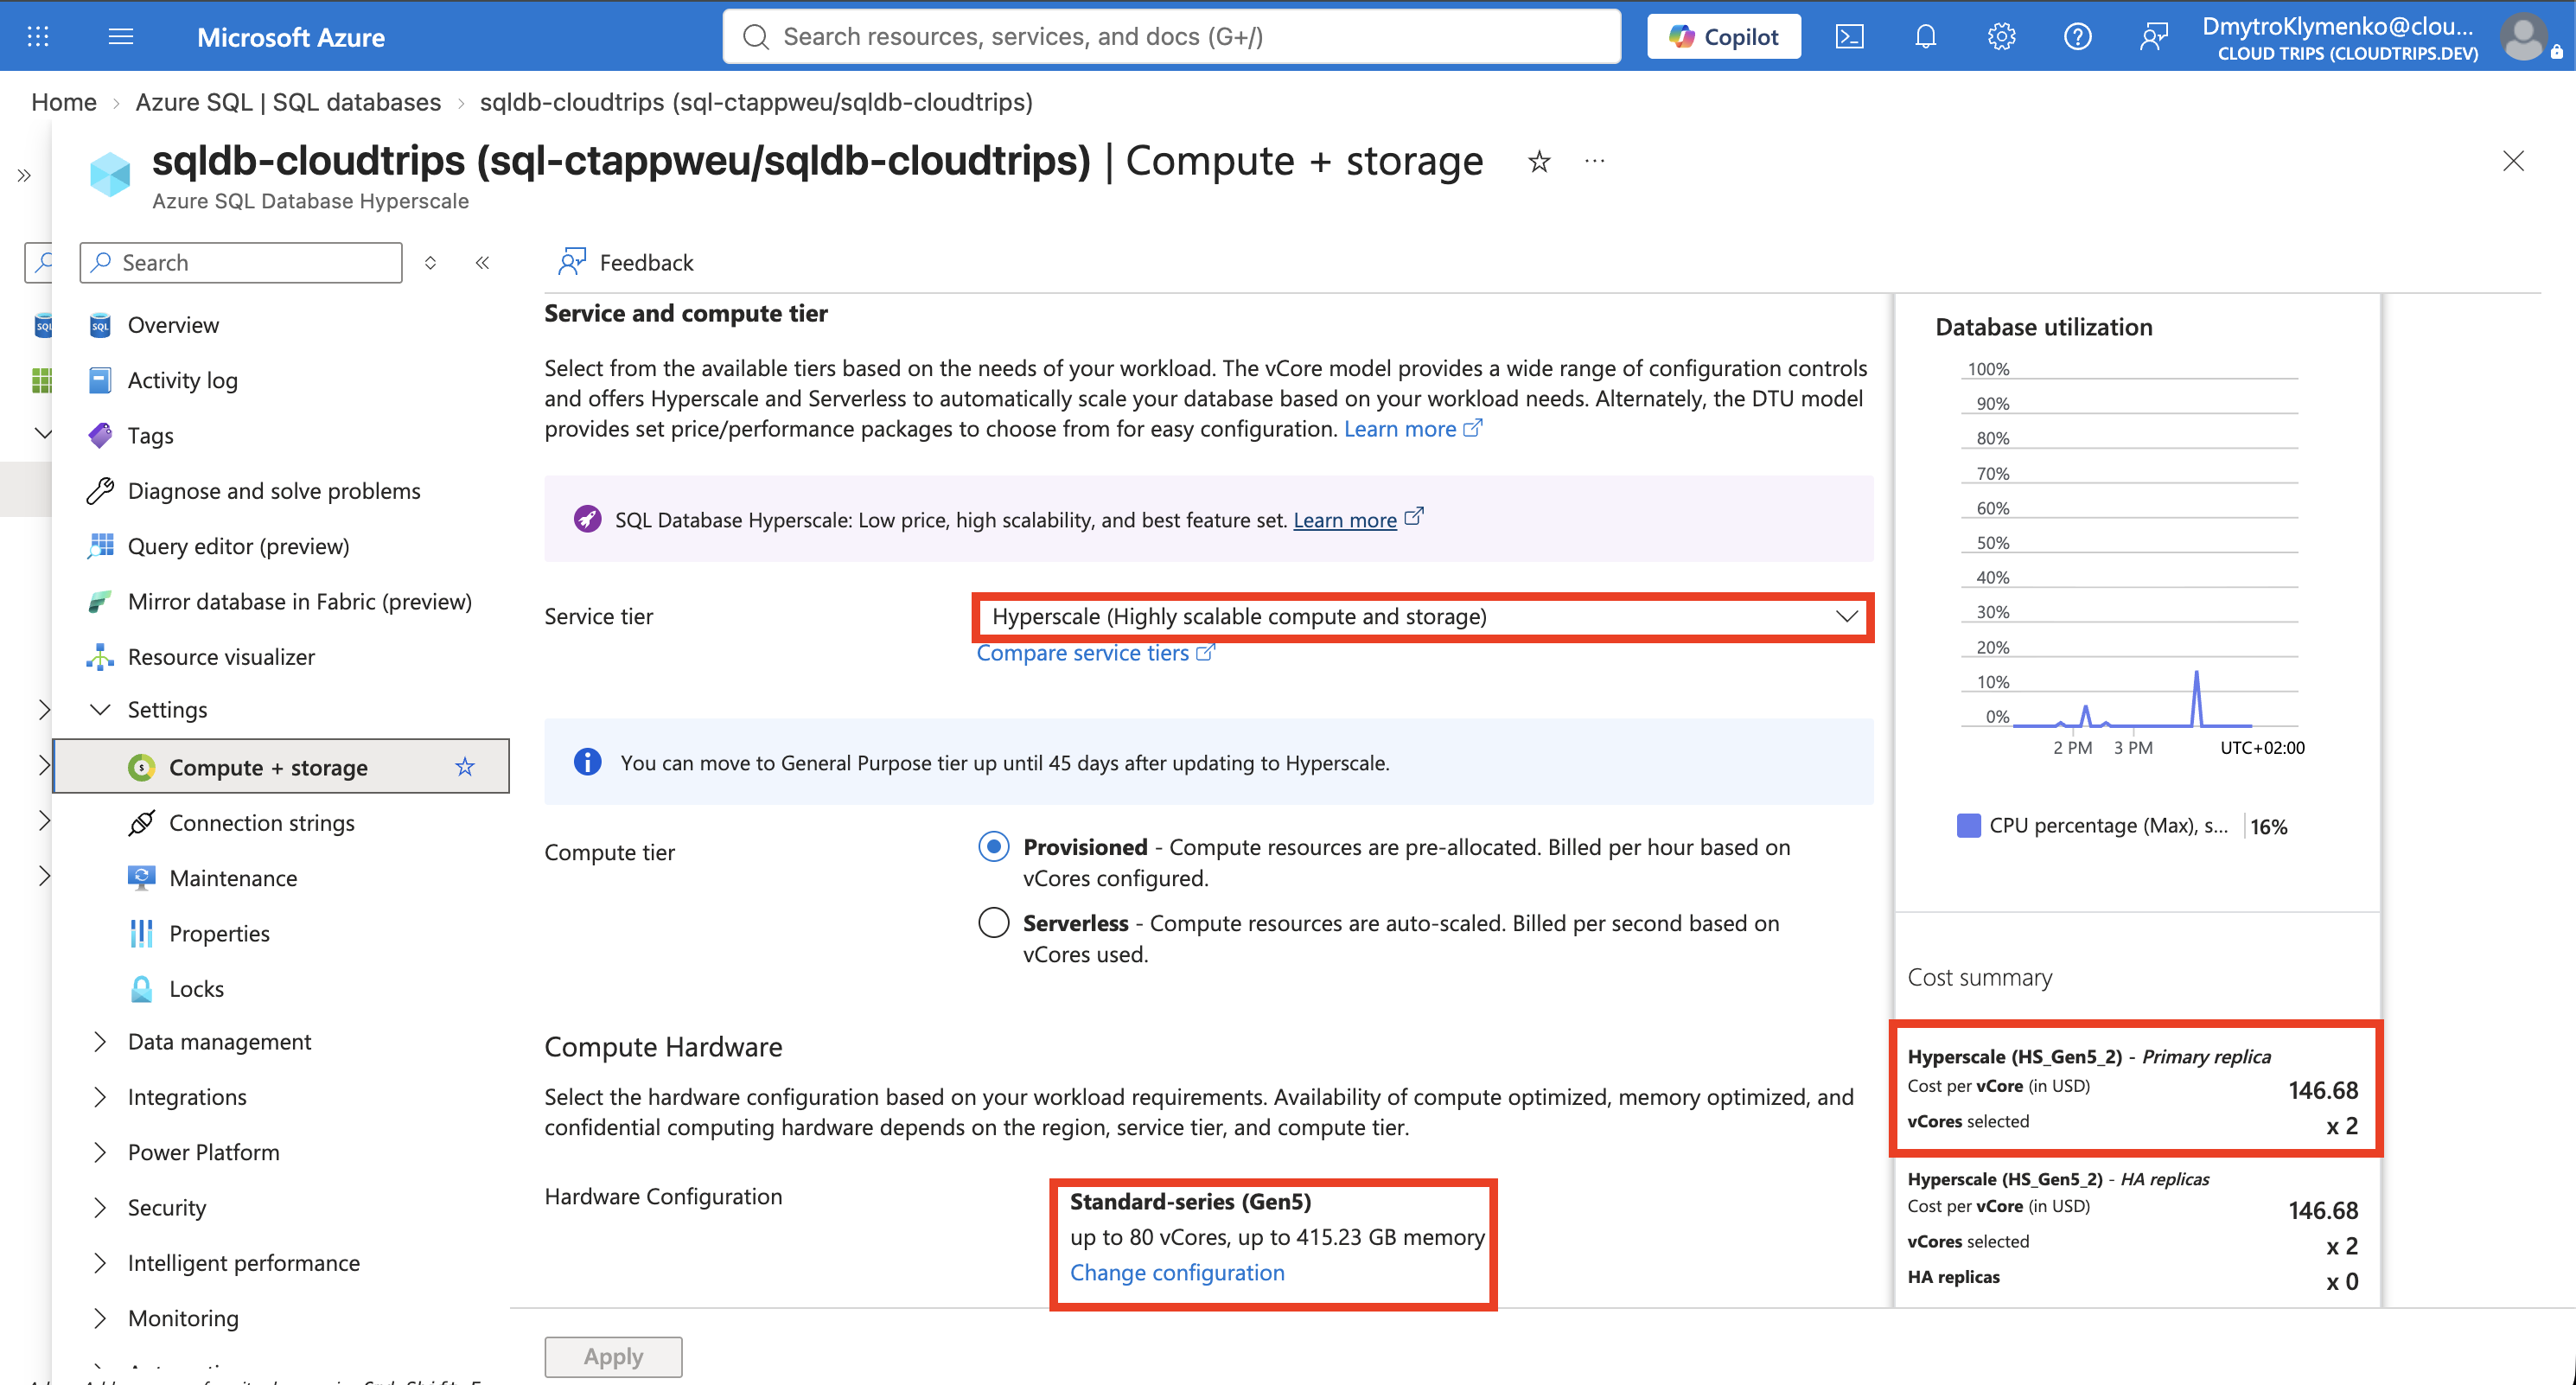
Prüfe Dienstebene, Kernanzahl und Replikatanzahl. Null Hochverfügbarkeitsreplikate senken die Labkosten; zusätzliche Replikate stellen Rechenkapazität für schnelleres Failover bereit. Bereitgestellte Rechenleistung bleibt auch im Leerlauf kostenpflichtig.
Verfolge den Fortschritt unter Overview → Notifications. Azure kopiert die Daten und schaltet die Datenbank auf Hyperscale um. Der automatische Cutover unterbricht Verbindungen kurz; verbinde dich anschließend erneut. Datenbankname und Serveradresse bleiben gleich.
Dienstebene prüfen
Verbinde dich über Query editor (preview) oder deine SQL-Verbindung in VS Code mit sqldb-cloudtrips und führe aus:
SELECT DB_NAME() AS DatabaseName,
       DATABASEPROPERTYEX(DB_NAME(), 'Edition') AS Edition,
       DATABASEPROPERTYEX(DB_NAME(), 'ServiceObjective') AS ServiceObjective;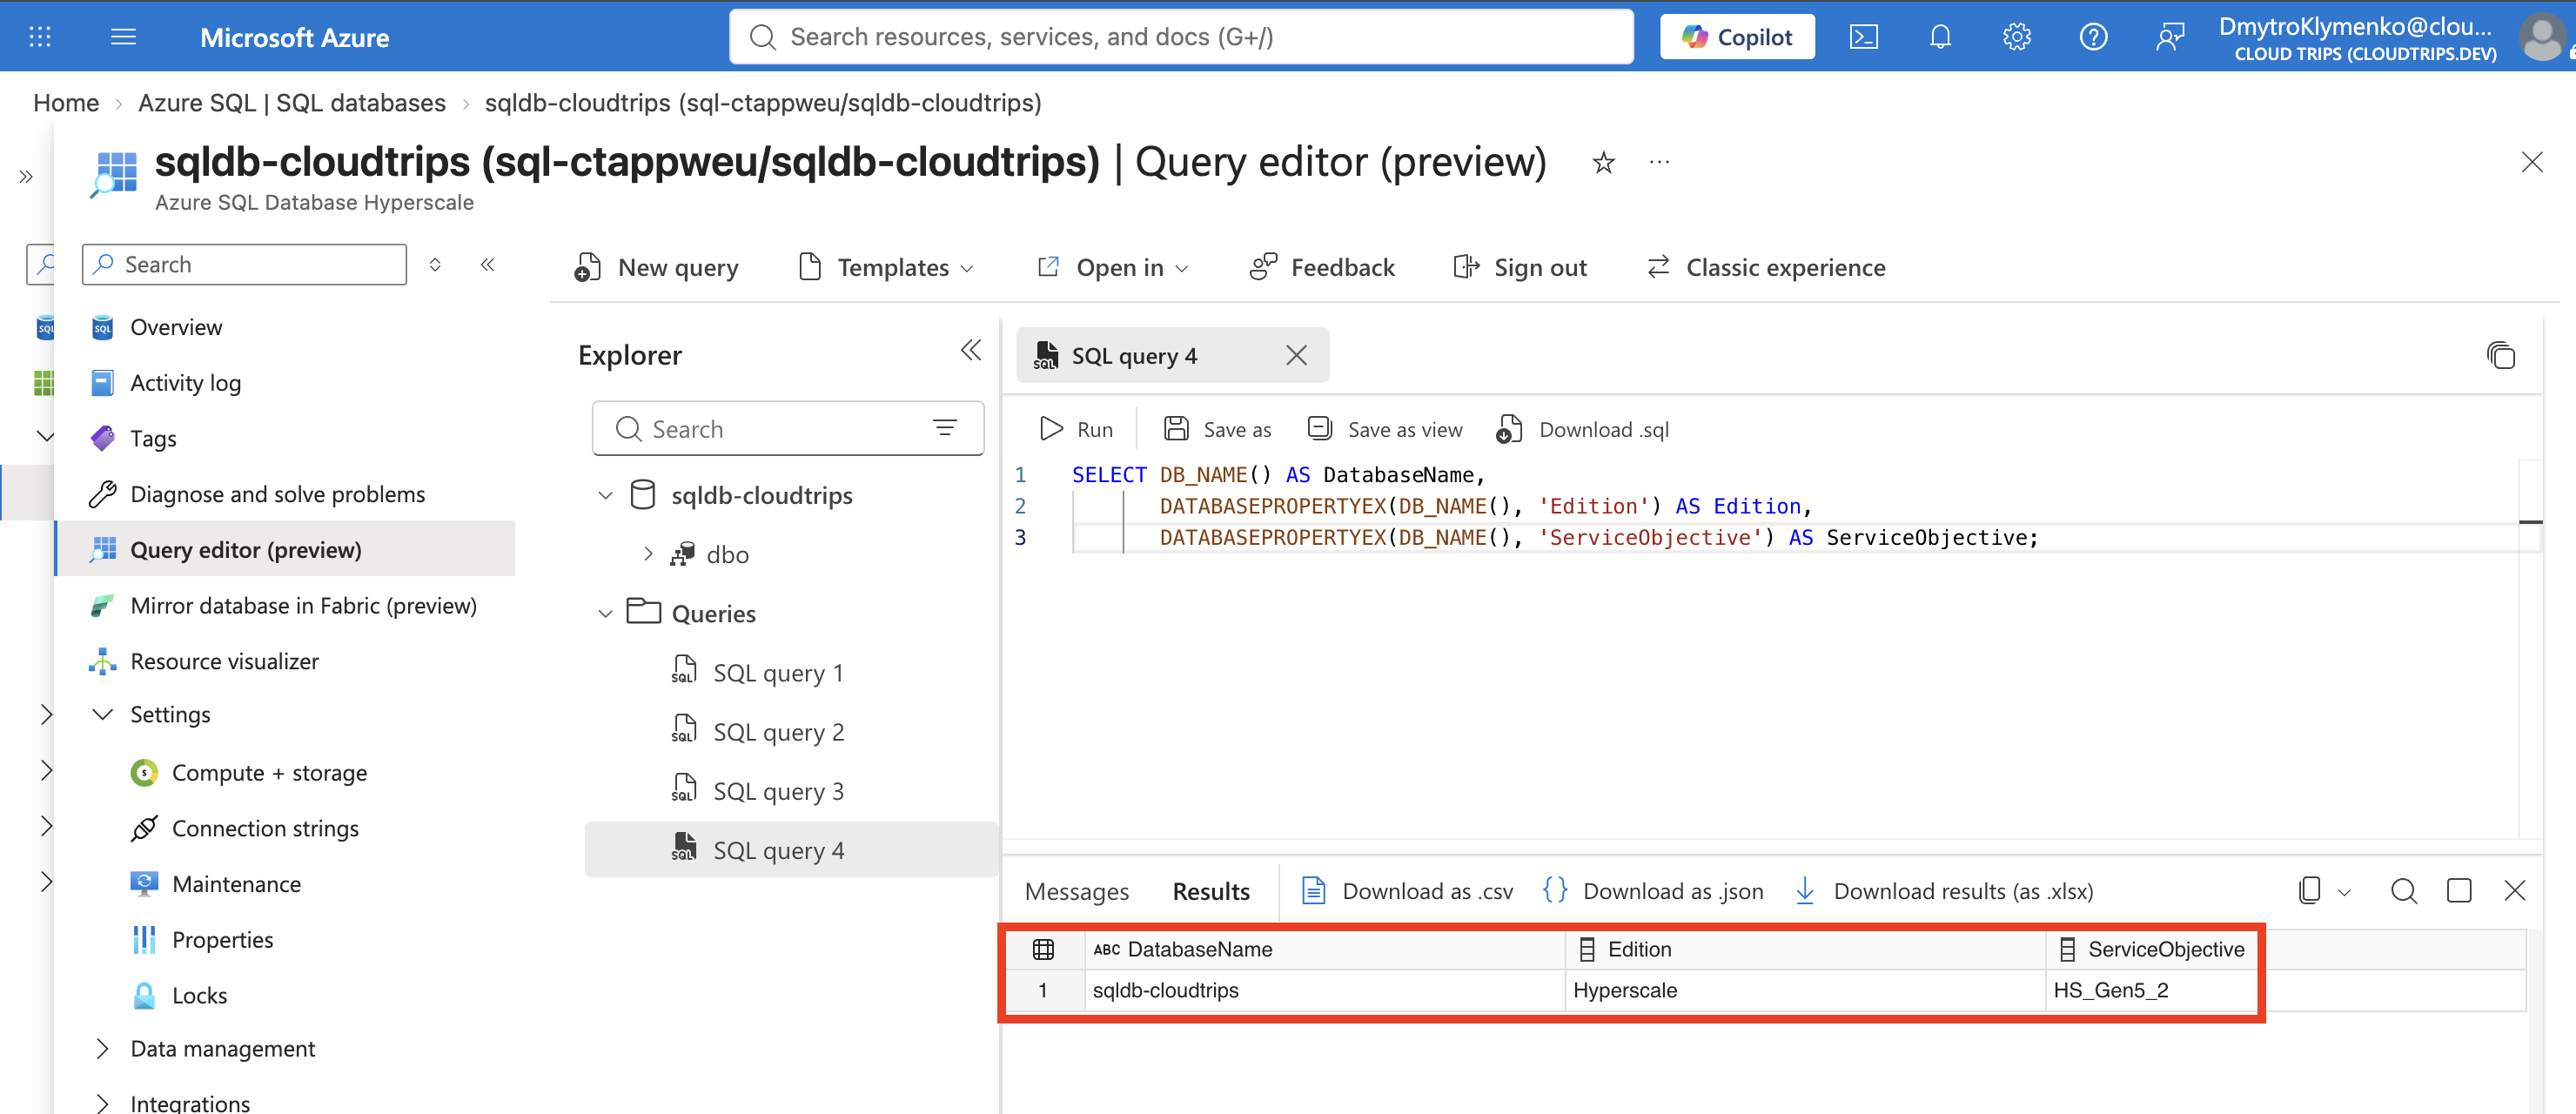
Erwarte für die gewählte Konfiguration sqldb-cloudtrips, Hyperscale und HS_Gen5_2. Das bestätigt die Dienstebene; Leistungstests bei großen Datenmengen benötigen repräsentative Daten und Abfragen.
Bereinigen
Lösche die Labdatenbank nach Abschluss. Lösche pool-ctshared separat, sobald er leer ist, falls er vom vorherigen Trip übrig ist; auch ein leerer Pool verursacht Kosten. Wenn alle Ressourcen in rg-cloudtrips-sql-test-weu entbehrlich sind, lösche stattdessen diese Ressourcengruppe.